地震预测常被理解为“准确说出下一次大震何时、何地发生”,但这不是当前地震科学能够给出的承诺。更现实的目标,是在明确的时间、空间与震级范围内,给出未来地震发生可能性的概率判断,并用事后的独立数据检验这种判断是否真的优于随机猜测。Ying Zhang、Chengxiang Zhan、Qinghua Huang 和 Didier Sornette 在 Geophysical Journal International 发表的论文 Forecasting future earthquakes with deep neural networks: application to California,将加州历史地震记录转化为一张随时间更新的“对数能量图”,再交给全卷积神经网络(FCN)学习未来地震的空间分布。值得关注的不是它单独展示了一个深度学习结果,而是作者把 FCN 放在空间背景率可变的增强 ETAS 模型旁边,进行了长期的准前瞻检验。结果显示,FCN 在多数时间—震级窗口中与 ETAS 的总体排序能力相近;但在把输出转换为实际预警时,概率校准和大震高等级预警仍是它绕不开的边界。
一、研究背景
近年来,地震预测研究中涌现了许多机器学习模型。然而,“模型优于随机泊松模型”并不等于它已经优于现有最强的地震预测方法。作者系统检索了 1994 年至 2023 年的 136 篇机器学习地震预测或预测论文,发现只有 66.9% 的研究与某种基准模型作过比较;而在这些比较中,不少基准只是随机模型、简单泊松模型或另一种机器学习方法。论文的立场很明确:如果要评价 AI 在地震预测中的实际价值,就应当让它与成熟的统计地震学模型竞争,尤其是 ETAS 模型。
ETAS 模型将某时空位置的地震活动表示为背景活动与既往地震触发活动的叠加,能够同时利用震级、时间衰减和空间聚集信息。它也是当前加州地震可预测性研究中极具竞争力的基准。本文没有将 FCN 与一个容易超越的“空白对照”比较,而是选择了带有空间变化背景地震率的 ETAS 版本;这一点决定了后面“性能接近”的结论具有更严格的含义。
研究使用加州 RELM 多边形范围内、1980 年 1 月至 2020 年 12 月、深度不超过 40 km 的 ANSS 地震目录。图 1a 显示地震并非均匀散布,而是沿主要断层系统形成密集带;图 1b 的频度—震级关系给出全时段约为 2.1 的完备震级估计;图 1c 则把 M≥3、M≥4 和 M≥5 事件的累计数与独立事件数并列,提示目录同时包含长期背景活动和短期触发聚集。
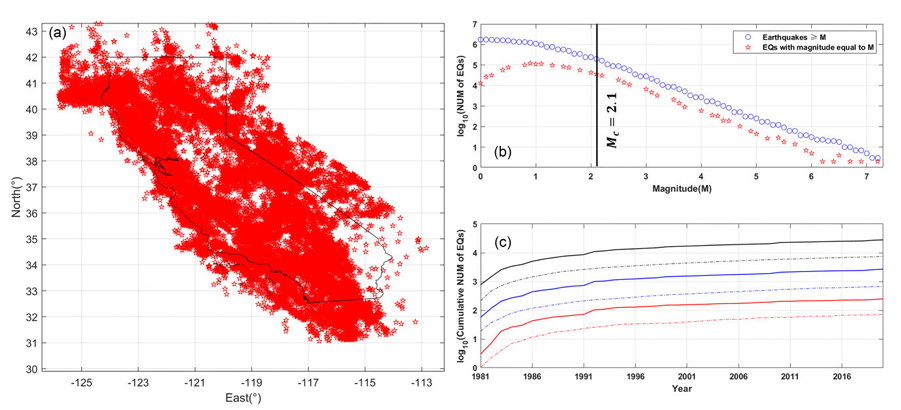
图 1 研究使用的加州地震目录。左图为震中分布,右上为频度—震级关系,右下比较不同震级阈值下完整地震序列与独立事件的累计数量。
二、全卷积网络模型
这项研究没有把每一场地震的发生时间、坐标和震级逐条送入网络,而是先做了一步物理启发下的特征构造。研究区被划分为 0.1°×0.1° 的空间格网,时间以 10 天为步长。对每次地震,作者依据震级估算释放能量和破裂长度,将能量按与震中距离递减的规则分配到周围格点;在某个格点、某个 10 天时间片内累加这些贡献,再取对数,便得到 FCN 的输入“图像”。这里的能量影响范围随破裂尺度变化:大震能够向更大的邻域贡献信息,小震的影响范围则较小。
网络以连续 700 天的历史能量图作为输入,输出整个研究区每个 0.1°×0.1° 格点在未来窗口内至少发生一次目标地震的数值。目标震级设为 M≥3、M≥4、M≥5,预测时窗设为 15、30、60、90 天,共构成 12 组独立实验。作者同时测试了两种输入目录:一种仅使用 M≥3 地震,另一种直接使用 M≥0 的更完整但并不完全完备的目录,以检验更小地震是否仍包含有用信息。
FCN 本身并不复杂。它由四个残差块和一个输出层构成,每个残差块由三层 3×3 卷积层组成,卷积核数依次从 16 降至 8、4 和 2,最后通过 1×1 卷积和 sigmoid 输出每个格点的结果。残差连接让网络可以在不堆砌庞大结构的情况下传递特征,也使该模型与“越深越好”的网络设计思路保持距离。
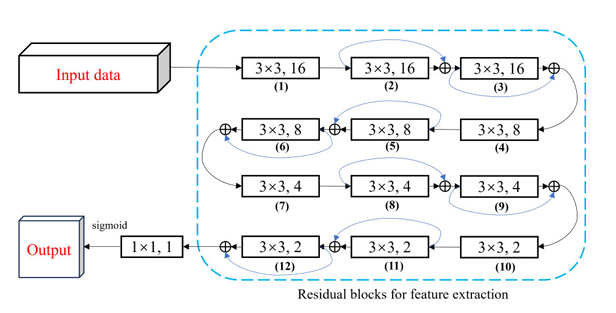
图 2 论文使用的全卷积网络。四个残差块负责从历史能量图中提取空间特征,最后的 1×1 卷积层将特征转换为研究区各格点的输出。
训练、验证与测试严格按时间分割:1990—1999 年用于训练,2000—2009 年用于验证,2010—2020 年用于测试。这样的安排避免了用未来事件训练过去时点的模型,也使后面的结果可以被视为一种准前瞻检验,而不是在同一批数据上反复拟合后的回代成绩。
三、模型对比
作为对照,作者使用的 ETAS 模型允许背景地震率随空间变化。该模型先用 1980—1989 年的 M≥3 目录完成初始标定,之后每 15 天更新一次参数,并通过 60 000 次模拟生成 1990—2020 年与 FCN 相同时间—震级窗口下的概率预测。也就是说,两类模型面对的是同一地区、同一目标震级和同一预测窗口,而不是各自挑选有利的任务。
论文以 Molchan 图评价预测能力。横轴 τ 表示被划为“报警”的时空体积比例,纵轴 v 表示漏报事件比例;在相同报警范围内,曲线越低,意味着漏报越少。虚线是随机猜测的基准,曲线与虚线之间的面积被定义为 area skill score,越接近 1 表示相对于随机模型的排序能力越好。这个指标衡量的是模型能否把更可能发生地震的时空单元排在前面,并不直接说明输出的数值已经是校准良好的真实概率。
图 3 的 12 个面板把不同震级阈值和预测时间逐一展开。对于 M≥3 和 M≥4 的目标事件,使用 M≥3 目录输入的 FCN 与 ETAS 的 area skill score 在大多数窗口相差不足 0.01。以 M≥3、15 天窗口为例,ETAS 得分为 0.891,FCN(M≥3 输入)为 0.881;当将 M≥0 的小震也纳入 FCN 输入时,得分达到 0.912。对 M≥5 的目标事件,FCN(M≥3 输入)在四个时间窗口的得分分别为 0.864、0.865、0.882 和 0.874,均略高于对应的 ETAS 得分 0.830、0.856、0.844 和 0.869。总体而言,FCN 的确在这套长期测试中接近,部分窗口还超过了 ETAS;但这首先是“排序表现”的结论,而不是“AI 已经更会报出可靠概率”的结论。
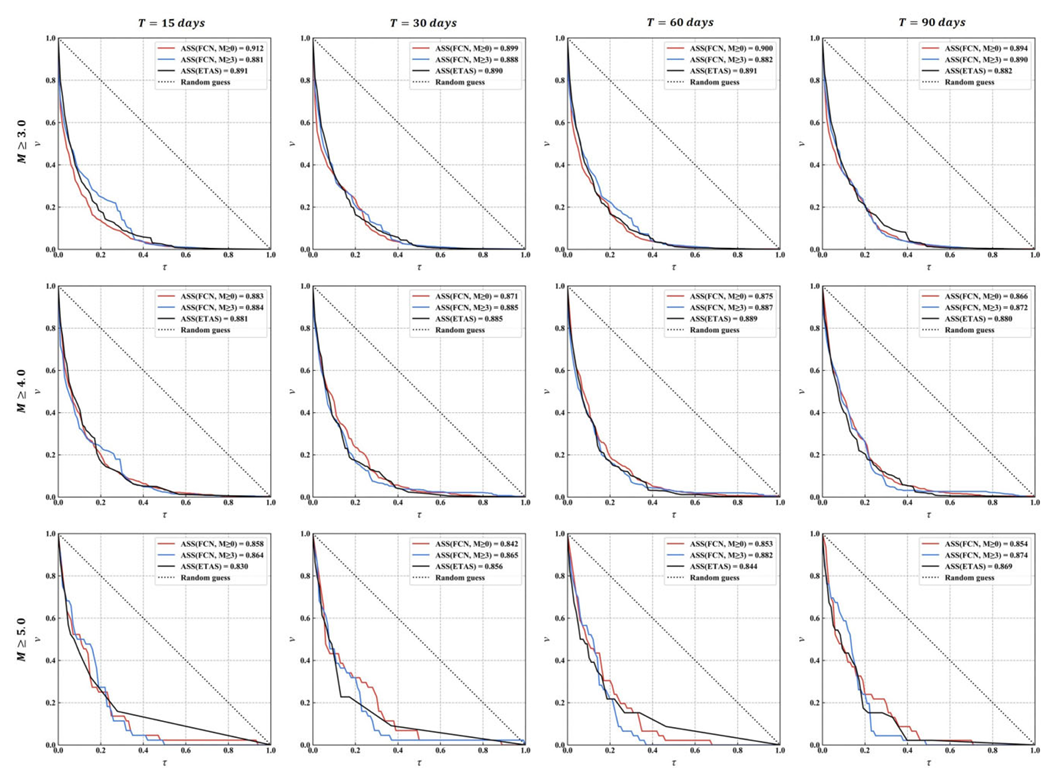
图 3不同震级阈值与预测时窗下的 Molchan 图。红线为使用 M≥0 输入的 FCN,蓝线为使用 M≥3 输入的 FCN,黑线为 ETAS;曲线整体位于随机猜测线下方,且三类曲线在多数面板中彼此接近。
四、从“概率”到预警等级
地震预测格网中,真正发生目标地震的正样本极少。以 15 天窗口为例,训练集中 M≥3 的正样本为 4,788 个,而负样本达到约 297 万个;M≥5 的正样本只有 78 个,负样本仍接近 298 万个。如果直接按普通均方误差训练,网络最容易学会的策略是对所有格点都输出接近零的结果——这在总体误差上看似不错,却没有任何预测价值。
作者因此对正样本损失进行再加权,使罕见地震在训练中获得更大的影响。但再加权也带来典型副作用:随着正样本权重提高,FCN 给出的平均输出值升高,对正样本的误差下降、对负样本的误差上升;模型倾向于报出比经验发生率更高的地震概率。图4中的红色虚线标出 0.15α:在此之前,增加权重能明显提高 area skill score;超过这一位置后,排序能力提升有限,概率却继续被推高。论文据此没有把 FCN 输出直接当作可解释的绝对概率。
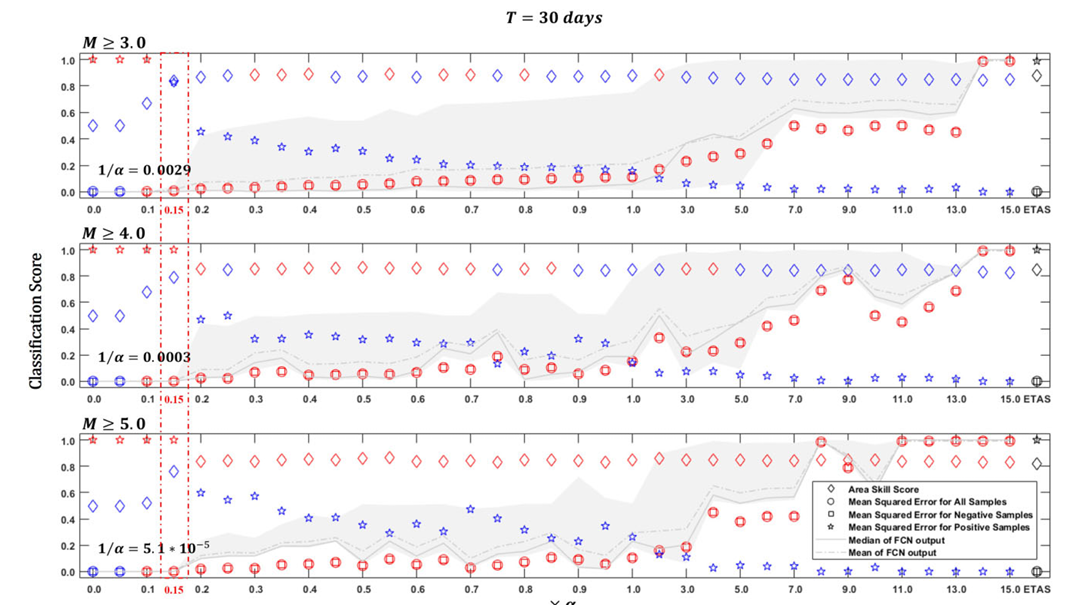
图 4 正样本权重变化对 FCN 分类指标的影响,三行分别对应 M≥3、M≥4 和 M≥5 的 30 天预测。红色虚线所示的 0.15α 是本文采用的权重;图中展示了排序能力改善与过度报高概率之间的权衡。
为此,作者提出将 FCN 和 ETAS 的连续输出转换为九级预警,而不是直接向公众展示一个看似精确的发生概率。训练集与验证集的输出按分位数划分:最低的 25% 对应 I 级,最高的 1% 对应 IX 级,VII—IX 级为高预警,IV—VI 级为中预警,I—III 级为低预警。这样的分级并不能消除模型不确定性,但它承认了概率校准尚未解决,并把连续输出转化为更容易沟通的相对风险等级。分界规则仍包含策略选择:若更在意少漏报,就可扩大高预警范围;若更在意少误报,则应缩小高预警范围。
2019 年 Ridgecrest 地震序列提供了一个直观案例。图 5 展示了 2019 年 6 月 28 日至 7 月 28 日、针对 M≥5 事件的预警图;其中 FCN 与 ETAS 使用的预测窗口均为 90 天。7 月 6 日发生的 Mw 7.1 Ridgecrest 主震及其前后多个 M≥5 事件落在图中标出的震中位置。FCN 给这些事件 VII 或 VIII 级预警,ETAS 给出 VI、VII 或 VIII 级;二者都识别出这一序列附近较高的相对风险。ETAS 对事件触发链的解释更明确:文中估计其中第一场 M≥5 事件与 6 月 4 日的一次 M4 事件高度相关,随后事件又构成触发序列。
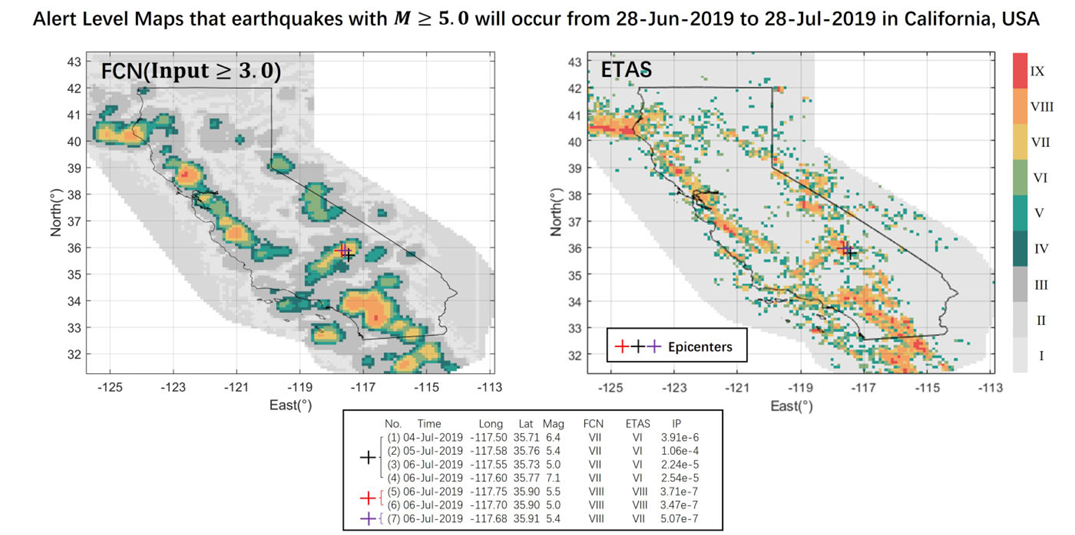
图5 针对 2019 年 Ridgecrest 序列的 M≥5 预警等级图。左图为 FCN,右图为 ETAS,图中“+”为随后实际发生的地震。两种模型给出的高等级区域和事件等级存在差异,但均在序列附近给出较高的相对预警。
五、模型优缺点分析
FCN 最突出的优势是计算效率。论文报告,在 RTX2080Ti GPU 上训练该网络约需 3 分钟,单次预测只需 4—8 秒;与之比较,ETAS 的参数反演约需 0.5 小时,60,000 次模拟约需 4 小时,完成一次概率预测约需 4.5 小时。就生成预测这一步而言,FCN 快约 2,000—4,000 倍。对需要反复试验输入特征、时间窗口和预警策略的研究而言,这种速度差会显著降低迭代成本。
另一项值得关注的结果是,FCN 不像 ETAS 那样依赖一个经过严格完备性分析的输入目录。将 M<3 的小震也并入输入后,FCN 在部分时间—震级窗口中表现更好,尤其对较小目标地震的预测有提升。这并不意味着目录完备性从此不重要,而是说明经由能量图聚合后,未完全检出的较小地震仍可能保留对后续活动有用的信息;FCN 与 ETAS 对目录质量的敏感方式并不相同。
局限同样不能忽略。首先,极端类别不平衡迫使 FCN 使用再加权,而再加权使输出值偏高,因此目前更适合解读为相对风险或预警等级,而非可直接用于决策的绝对概率。其次,针对 M≥5 的高预警等级,ETAS 在保持相近或更小报警时空体积的条件下,通常具有更高的命中率;这与前面 FCN 在整体 area skill score 上的细小优势并不矛盾,因为二者关注的分别是全阈值范围的排序表现和高阈值报警的实际取舍。最后,FCN 从能量图中学习统计关联,却没有显式分辨背景事件与触发事件;在解释一场地震为何被报高风险时,ETAS 的触发链结构仍提供了 FCN 所没有的统计地震学信息。
六、总结
这篇论文的核心贡献,是用一个结构并不复杂的全卷积网络,与强基准 ETAS 模型进行直接、长期的加州地震预测比较。它表明:将历史地震释放能量按空间与时间聚合为对数能量图后,FCN 可以在 M≥3、M≥4 和 M≥5、15—90 天等多组任务中达到与 ETAS 接近的总体排序表现,同时以显著更低的计算成本生成预测。
但这并不是“深度学习已经解决地震预测”的结论。论文最有价值的部分恰恰在于展示了它的边界:模型在极端不平衡数据下难以给出校准良好的绝对概率,大震高等级报警仍有 ETAS 更占优势的情形。对地震预测而言,AI 的意义不在于用更深的网络替代已有理论,而在于接受严格比较、把输入信息转化为可检验的预测,并与统计地震学模型共同改进风险判断。
论文引用: Zhang, Y., Zhan, C., Huang, Q., & Sornette, D. (2025). Forecasting future earthquakes with deep neural networks: application to California. Geophysical Journal International, 240(1), 81-95. https://doi.org/10.1093/gji/ggae373